

Jenny Halasz habla sobre Canonicals en #AskAnSEO
Nota del editor: Bienvenido a Ask an SEO, la primera de una columna quincenal con diferentes expertos cada pocos meses. ¿Quieres hacerle a Jenny una pregunta sobre SEO? Complete nuestro formulario o use #AskAnSEO en las redes sociales.
El primer lote de preguntas que recibimos fue sobre el uso canónico y las mejores prácticas con respecto a ayudar a los motores de búsqueda a rastrear sitios de manera más efectiva. Pensé que podría ayudar comenzar dando algunos antecedentes sobre por qué esto es importante para el SEO. Para aquellos que no estén familiarizados con el presupuesto de rastreo como término, se refiere a la cantidad de tiempo que un motor de búsqueda (como Google, por supuesto) dedicará a intentar acceder a la información de su sitio. En la mayoría de los casos, no tiene una cantidad de tiempo ilimitada, porque Google tiene muchos otros sitios para rastrear. Por eso es importante poner las cosas en orden y ayudarles a ahorrar tiempo. Hay muchas formas de hacer esto, pero se reduce principalmente a la coherencia y el enfoque.
Anuncio publicitario
Continuar leyendo a continuación
Consecuentemente Hacer referencia a las URL de la misma manera, ya sea en enlaces internos, con canónicos o en su mapa de sitio XML, puede ayudar a los motores de búsqueda a comprender qué versión de una página es más importante para usted. Los problemas más comunes que ocurren con la coherencia son las URL a las que se puede acceder con o sin www, con o sin https, y con o sin barras (llamadas barras al final) al final de los nombres de los archivos. Es mejor elegir una variación y ceñirse a ella.
Enfoque los motores de búsqueda en lo que es más importante es el otro elemento clave en el control del presupuesto de rastreo. Puede hacer esto de muchas maneras diferentes, con varios tipos de archivos y comandos, como robots.txt, noindex y la designación de prioridad del mapa del sitio xml.
Cada uno tiene su propio propósito y no son intercambiables. Sin embargo, la mejor manera de enfocar el motor de búsqueda es usar consistentemente (¡hay esa palabra nuevamente!) Usando las mismas URL y usando enlaces internos para enfatizar cuál es más importante. No es casualidad que la mayoría de los sitios web tengan una navegación principal desde la que se accede a todas las páginas del sitio. Una buena navegación interna del sitio se ve como un árbol cuando lo grafica.
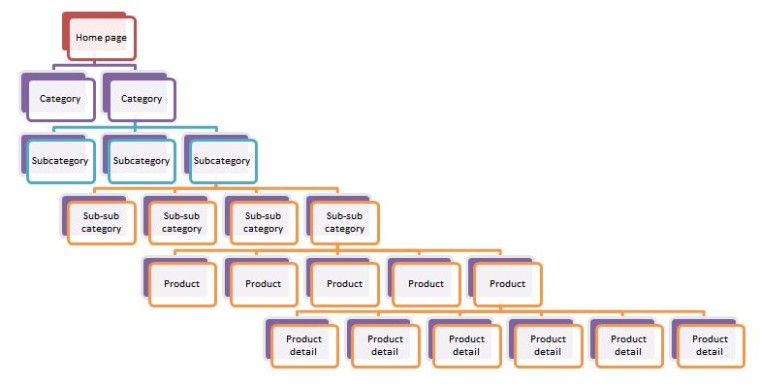
Por cierto, esta es la razón por la que la teoría de que todo el contenido del sitio no debe estar a más de tres clics de la página de inicio es una tontería. Cuanta más información tenga para compartir, más niveles de profundidad tendrá que recorrer el contenido. No estoy sugiriendo que agregue subdirectorios o subcategorías donde no sea necesario, pero permita que prevalezca la lógica. Si tiene cien mil productos individuales, algunos de esos enlaces de productos deberán estar a más de tres clics de la página de inicio.
Anuncio publicitario
Continuar leyendo a continuación
¡A las preguntas!
“Veo muchos sitios web aclamados que utilizan la etiqueta rel = canonical de autorreferencia en cada página de su dominio. ¿Por qué están haciendo esto? ¿Debería implementar la misma táctica? «
La etiqueta rel = canonical es una señal, no un comando definitivo. Si bien ciertamente no es una mala idea incluir un canónico en cada página, esta es también una forma en que muchos sitios (especialmente los sitios muy grandes) causan problemas por sí mismos. Si configura el canónico para que sea verdaderamente autorreferencial, entonces cada versión posible de esa página tendrá su propio canónico. Cuanto más canónicos ve un motor de búsqueda que son «falsos», es más probable que el motor de búsqueda no confíe en ninguno de sus comandos canónicos.
Por ejemplo, supongamos que ha decidido que la versión principal de su sitio se estandarizará en el protocolo https, con www y con una barra diagonal. Entonces, una página en su sitio podría ser: https://www.site.com/things/
Con un canónico verdaderamente autorreferencial, una solicitud de http://site.com/things mostraría que el canónico es
<link rel="canonical" href="http://site.com/things" /> – y sabemos que eso no es correcto porque no usa www, el protocolo https o barra diagonal.
Entonces, para que este canónico funcione correctamente, una solicitud para esa segunda página debe tener el siguiente comando rel = canonical asociado:
<link rel="canonical" href="https://www.site.com/things/" />
Además, tenga cuidado de hacer cosas solo porque los sitios grandes lo hacen. En mi experiencia, muchos sitios realmente grandes se equivocan en estas cosas simples, pero su valor de enlace masivo u otros elementos superan el problema. Cuando solucionan estos problemas, generalmente se benefician al igual que usted.
Después de agregar https: // www, https: //, http: // www, http: // versiones de mi sitio en Google Search Console, según sus instrucciones, ¿Cómo debería verse el enlace rel = canonical para el sitio de 1 página? ?
https://www.websitename.com, https://www.websitename.com/ o https://www.websitename.com/index.html?
Anuncio publicitario
Continuar leyendo a continuación
La respuesta es que debes estandarizar en uno. Tome una decisión sobre cuál usará y use el comando rel = canonical para señalar todas las demás versiones a la versión estándar. Si bien no es definitivo, intente evitar el uso de un nombre de archivo como /index.html como página de inicio de su sitio web principal. Hay muchas razones para esto, pero la más práctica es que la mayoría de las personas que se vinculan a su sitio no recordarán incluir el nombre del archivo. También recuerde que rel = canonical es solo una sugerencia, y la redirección 301 de estas páginas es una mejor estrategia.
¿Mi archivo sitemap.xml debe incluir https://www.websitename.com/ Y https://www.websitename.com/index.html? ¿Podría confirmar las mejores prácticas en esta situación?
No. Su archivo sitemap.xml debe incluir solo la versión estandarizada de una página determinada. Si ha decidido estandarizar en http://www.websitename.com, esa debería ser la única versión que incluya en su archivo sitemap.xml. La única excepción a esto es cuando se trata de varios dominios y se utilizan etiquetas Hreflang, pero esa es otra cuestión por completo.
Anuncio publicitario
Continuar leyendo a continuación
Si alguien no tiene algo que escribir en el archivo robots.txt, ¿debería enviar uno en blanco para evitar que los robots creen 404?
Es tu decision. La mejor práctica es tener un archivo robots.txt estándar que utilice el comando:
User-Agent: *Disallow:
Esto indica que no se permite nada en el sitio. En realidad, esto es muy raro. Incluso con un sitio de WordPress, querrá no permitir ciertas áreas del sitio que están destinadas solo a administradores. Sin embargo, si no utiliza un archivo robots.txt, el motor de búsqueda asumirá que el sitio está abierto y no se prohíbe nada.
Si bien no es obligatorio, también recomiendo a los webmasters que incluyan un enlace a su mapa del sitio XML en su archivo robots.txt, ya que este es un lugar principal donde Google y otros motores de búsqueda lo buscan. Para hacer esto, simplemente cambie el archivo de ejemplo anterior a:
User-Agent: *Disallow:sitemap: https://www.website.com/sitemap.xml
Anuncio publicitario
Continuar leyendo a continuación
Solo asegúrese de reemplazar la URL con la ubicación real de su mapa del sitio XML, teniendo cuidado de usar la versión http / https y www / non adecuada.
¡Gracias por las excelentes preguntas! Si bien siempre nos complace responder cualquier pregunta que envíe. El próximo mes probablemente nos centraremos en las métricas y la medición para SEO.
¿Quieres hacerle a Jenny una pregunta sobre SEO? Complete nuestro formulario o use #AskAnSEO en las redes sociales.
Créditos de imagen
Imagen destacada: Imagen de Paulo Bobita
Foto en la publicación: Imagen de Jenny Halasz


