
Analyse de variance
L'analyse de la variance, ou ANOVA (analyse de la variance), sont des techniques d'analyse des dépendances multivariées utilisées pour déterminer s'il existe des différences significatives entre les moyennes de trois groupes de population ou plus.
Par conséquent, avec cette analyse, nous découvrirons s'il existe des différences entre certains groupes lorsque nous modifions une ou plusieurs caractéristiques. Pour le savoir, nous utilisons la valeur moyenne des données.
Son utilisation est très fréquente dans des domaines tels que l'économie ou la médecine.
Hypothèses antérieures de l'analyse de la variance
Il existe un certain nombre de conditions préalables à la réalisation d'une ANOVA qui doivent être connues. Celles-ci sont essentielles pour que les résultats soient adéquats.
- Premièrement, la population doit suivre une distribution normale. On a donc affaire à un type de contraste paramétrique, puisque les paramètres de population de la moyenne et de l'écart type sont connus.
- De plus, les échantillons utilisés doivent être indépendants les uns des autres. Cela signifie qu'une modification de l'un d'eux n'a pas à affecter la valeur des autres.
- En revanche, les variances des populations étudiées doivent être égales. C'est ce qu'on appelle l'homoscédasticité.
Classification de l'analyse des modèles de variance
Pour l'analyse des modèles de variance, les trois classifications présentées ci-dessous peuvent être utilisées:
- Modèle d'effets fixes: Les populations sont normales et ne diffèrent que par la valeur de leurs moyennes respectives.
- Modèle d'effets aléatoires: Dans ce cas, les données ont une hiérarchie et les différences de population en dépendent.
- Modèle d'effets mixtes: Nous serions confrontés à un modèle qui est un mélange des deux précédents.
Exemple ANOVA: concepts importants
Il existe des équations mathématiques d'une certaine complexité pour effectuer l'ANOVA. Cependant, dans Economipedia, nous avons opté pour l'économie simple et, par conséquent, et en profitant de la technologie, nous allons montrer comment cela pourrait être fait dans un tableur.
Imaginons que l'on veuille savoir s'il existe des différences significatives entre les lecteurs d'Economipedia, en fonction de l'affinité de leur diplôme avec l'économie.
Attention: les données que nous utiliserons sont fictives.
Nous devons aller à Data, Data analysis et nous choisirons l'analyse de variance d'un facteur.
Le rang serait la matrice des trois groupes. Il peut être plus intéressant d'inclure les titres par la suite et de donner le formatage souhaité. Dans notre cas, avec le logo et la couleur bleu.
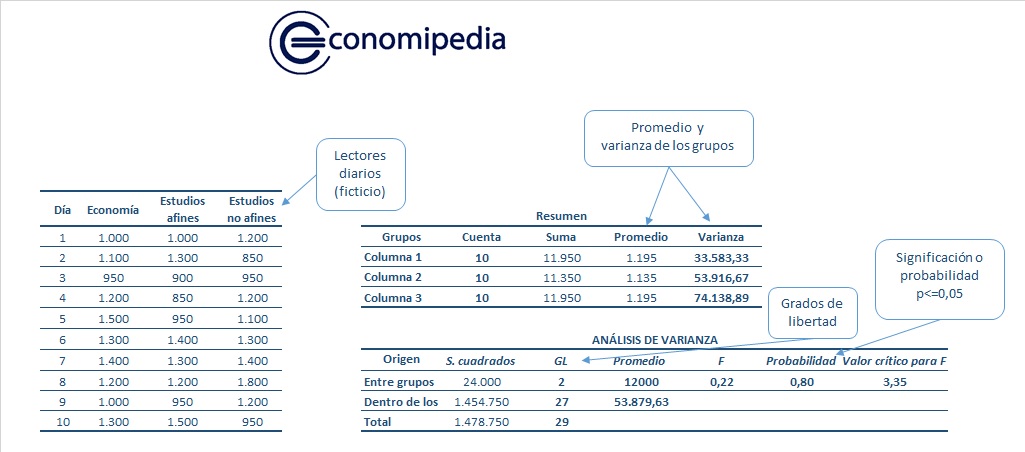
Nous voyons qu'il existe certains concepts tels que les degrés de liberté et la probabilité ou la signification. Le premier est calculé automatiquement et correspond au nombre de groupes moins un. La seconde nous dit si les différences sont significatives ou non.
Habituellement, vous partez d'un niveau de confiance accepté. En économie, il est généralement de 95% (0,95), ce qui est lié à une signification de 0,05 (1-0,095). De cette manière, si cette probabilité ou valeur p est inférieure à la signification acceptée, les différences sont significatives.
Dans ce cas, il semble que le degré n'influence pas le nombre de lecteurs (signification> 0,05). Par conséquent, l'analyse de la variance semble indiquer qu'Economipedia intéresse tout le monde, pas seulement les lecteurs spécialisés. Bien sûr, ce sont des données fictives ou pas?


Laisser un commentaire